AI开放,平衡有术
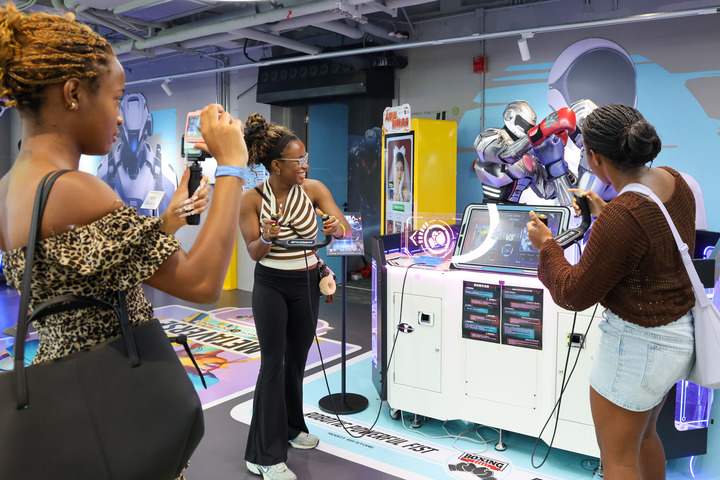
2026 年 8 月 4日,来自牙买加的游客在深圳龙岗全球首家机器人 6S 店参与互动游戏
《环球》杂志:开放生态如何兼顾创新、商业回报和知识产权保护的平衡?
周鸿祎:开源先解决用户量,再用规模换标准。模型厂商基于生态获得广泛的技术创新、用户选择和商业收益。这样企业能放心地部署自主可控的主权AI,形成良性循环。这是一种周期更长的回报方式。
开源生态能吸引大量的用户,用户用的多,改完愿意反馈,使用数据进入下一轮训练,用户成了共同开发者,并增强了企业的创新活力。
用户规模做大后,开源模型成为广泛的根技术和基础设施。闭源模型能力只比开源高10% 到15%、价格却贵几十倍,开源的市场竞争力巨大。未来无人车、无人机、机器人都必须靠端侧算力跑本地模型,因为,网络中断或延迟直接关系到安全,这块市场也只有开源的端侧模型接得住。
在知识产权方面,通识能力取自开源基座,组织和企业专有的能力可以通过后训练在自己的服务器上。换句话说,开放的是公共底座,私有的是企业的私密数据和竞争壁垒。
范振发:需分层开放。接口、协议、连接标准应开放;像核心算法、健康模型、数据资产和认证能力这类则需要保护。开源做连接,核心做壁垒。该连接的连接,该保护的保护,该共享的共享,才能创新与回报兼顾。
薄满辉:开源生态极大地推动了生成式人工智能的发展。以中国为例,中国企业在生成式AI开源生态构建过程中发挥了重要作用,一方面体现了中国科技企业对技术趋势的精准洞察和推动科技成果普惠化的情怀,另一方面,也说明中国资本市场和社会环境对开源生态的发展模式给予了肯定。当然,开放生态模式发展能否持续,企业的持续创新是基础,外部环境能否形成给予的企业持续正反馈是关键,核心是要建立起让真正推动科技普惠化发展的企业和组织不会吃亏的市场机制。
陈天润:在商业的语境下,开放和保护从来就是一个硬币的两面,它们共同构成一个完整的整体。对于基础技术而言,开放能够促进协作、降低重复建设、扩大应用范围;对于企业而言,商业回报则是持续投入研发、维护产品和承担责任的基础。关键在于建立清晰的开放边界和权利边界。
首先,开放可以分几个层次。模型论文、基础工具、接口标准、评测方法和部分代码可以通过开源促进生态发展;涉及核心训练数据、关键工程优化、商业客户数据和面向行业的专属能力,则需要采取授权、私有化部署或合作开发等方式。不是所有内容都必须以同一种方式开放。
其次,知识产权归属和使用范围要更明确。开源项目应清楚地说明许可证、商业使用条件、模型权重和训练数据来源,避免使用者无法判断哪些内容可以修改、复制和商业化。企业在合作中也要明确原始数据、标注数据、模型参数、衍生资产和应用成果分别归谁所有。
第三,要让贡献者获得合理回报。开放生态的价值不仅来自代码发布,也来自数据、算力、场景、测试和应用贡献。可以通过商业授权、云服务、技术支持、行业解决方案及生态分成等方式,使开源成果形成可持续的商业循环。
开放,不是把所有能力无差别地放出去,而是通过合理开放让更多人参与创新,同时用明确的授权和责任机制保护研发投入。最终目的是让更多技术进入真实场景,而不是让企业失去持续创新的能力。
段永朝:首先应正确理解三者的关系,而非在三者之间简单折中。
第一,开放生态不是宣传用语,而是制度保障。如果现行制度不利于开放创新,口头倡导的“开放”就是一句空话。典型现象是“开放洗白”:以开放之名获取社区贡献,收益与控制权却集中在少数方手里。
第二,“使用权”比“所有权”更适合作为新的制度抓手。我认同把隐私与知识产权的问题,从“定义隐私”转向“定义使用权”。数据与知识的价值往往在被使用时才产生,制度设计的重点应从“谁拥有”转向“谁可以在什么条件下使用、使用后各方怎样分享”。
第三,制度根基需重新思考。现行经济制度大体延续工业时代以所有权为核心的生产、消费、激励与产权安排。而智能经济的价值是多方共创的:数据提供者、知识作者、开源维护者、劳动者、用户、平台与投资者。因此需重新讨论效率与公平的关系,进而重新认识价值创造、财富分配、共同富裕与知识产权保护。主导性的企业实践与绩效评价,常把可计量的效率与资本回报放在中心,把分配与长期公共后果当作外部问题。这不适用于智能时代。
我认为,制度设计可以有以下四个抓手:
明确权利:哪些可开放,哪些受隐私、商业秘密、合同与版权约束。
保障参与:规则透明,避免平台单方面更改接入与收益条件。
建立分账:既要有实时结算的技术,也要有协商、审计与申诉的规则。“支付即结算”解决账期,不解决“按什么分”。可参考Benkler的共同体生产、Ostrom的公共资源自治、Lanier的数据尊严。
保证问责:安全、侵权与损害责任不因“开放”而消失。现有许可证仍有重要作用。宽松许可证、GPL、AGPL提供不同强度的共享与回馈机制,但许可证只能处理一部分权利,不能替代劳动保护、竞争政策与收益分配制度。
郝彬彬:我的理解是底层技术开源共享,场景能力闭源增值;通用能力开放共建,核心商业自主可控。对通通达来说,对于基础算法、通用框架我们积极拥抱开源,也会向社区贡献产业场景数据;但针对垂直场景的调度模型、车控算法、Physical AI运营平台的核心模块,都是我们自主研发的。
开放生态的本质是用开源促进创新,用商业化落地反哺研发,形成“开源共建-场景增值-商业回报-反哺开源”的正向循环。既不能闭门造车,也不应把核心商业能力全部开放,找到生态贡献和企业发展的平衡点。
宋亚宸:VAST对这个问题有非常切身的实践体会。我们的策略可以概括为“底层开源、上层商业、核心自研”三层结构。
底层开源:把基础模型的权重和推理代码以MIT协议开放出去。MIT协议允许商业使用,没有copyleft约束,这对开发者最友好,也最有利于生态扩散。
上层商业:我们的商业产品提供持续迭代的最新模型、稳定的API服务、企业级的技术支持和定制化能力。开源版本和商业版本之间存在明显的能力差距和服务差距,这是我们商业回报的来源。从实际表现看,开源不但没有损害商业收入,反而是商业增长的最大漏斗。
核心自研:我们的训练数据、管线、最新的模型架构创新,以及面向垂直场景的定制能力,这些都不开源。

 手机版